데이터 라벨러

자율주행이나 자연어 인식 같은 인공지능 프로그램을 개발할 때, 학습 데이터를 인공지능이 쉽게 인식하도록 라벨(정보 표식)을 모아 입력하고 가공하는 직업이다.

데이터 라벨러 직업 종사자가 업무를 수행하는 모습
AI훈련데이터어노테이션머신러닝재택가능이미지라벨링NLP

직업 상세 정보 탭

방향키로 탭을 이동하고 Enter 키로 선택할 수 있습니다. Home/End 키로 처음과 마지막 탭으로 이동합니다.

주요 업무

수행 직무

  • ▶ 프로젝트 가이드는 작업에 들어가기 전에 숙지해 둔다.
  • ▶ 이미지·영상 촬영과 음성·사운드 녹음 중 하나를 수행해, 조건에 부합하는 결과물을 업로드한다.
  • ▶ 촬영·녹음 대신, 상황에 알맞은 Q&A 데이터셋을 생성하는 업무를 맡을 수도 있다.
  • ▶ 마우스 드래그로 이미지에서 정해진 대상에 박스를 그린다.
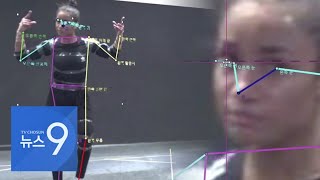
  • ▶ 스켈레턴 추출작업은 대상의 특정 부위에 점을 찍는 방식으로 이루어진다.
  • ▶ 얼굴 표정을 보고 사진 속 사람의 감정을 추론해 태깅하는 일과 이미지를 글로 상세하게 묘사하는 일 중 하나를 맡는다.
  • ▶ 영상에서 고객사에 필요한 데이터를 기준으로 구간을 선택해 추출한다. 이때 화자가 특정 동작을 하거나 특정 대사를 말하는 순간이 구간 선택 시점이다.
  • ▶ 구간 추출 후에는 감정 태깅이나 대사 받아쓰기 중 한 가지를 수행한다.
  • ▶ Q&A 대화는 주어진 시나리오에 맞게 만들며, 이 대신 제시된 지문을 읽고 질문을 만드는 업무를 하기도 한다.
  • ▶ 주어진 지문을 읽은 뒤 핵심 내용을 요약하는 작업이 있다. 주어진 문장을 읽은 다음 의미가 서로 같은지 다른지 태깅하는 일도 있다. 주어진 문장에서 느껴지는 감정을 읽고 태깅하는 작업도 한다.
  • ▶ 들리는 대로 주어진 음성을 받아쓰는 업무를 한다.
  • ▶ 먼저 기준음성과 비교 대상음성을 들은 다음, 화자가 서로 같은지 다른지 태깅한다.
작업강도

아주 가벼운 작업

작업장소

실내

육체활동

시각

커리어 전망

정부는 한국판 뉴딜 데이터 댐 사업으로 2025년까지 AI 학습용 데이터 1,300종을 추가 구축할 계획이며, 이 사업으로 2025년까지 90만3천 개의 일자리를 창출할 것으로 전망했다.[1] 생성형 AI·대형언어모델 학습을 위한 데이터 수요가 늘면서 라벨러 수요도 늘었지만, 자동 라벨링·합성 데이터 기술 발전으로 단순 반복 작업은 자동화될 위험이 있어 고난도 전문 라벨링으로의 역량 전환이 필요하다.

워라밸 & 사회적 평가

워라밸 지수

보통 이상

사회적 기여도

보통

워라밸

AIWORKX는 자사 플랫폼에서 누구나 언제 어디서나 이미지·영상·음성 데이터 수집부터 라벨링까지 원하는 시간에 참여할 수 있다고 소개한다.[2] 이런 유연성 덕분에 재택·부업 형태로 일하는 라벨러가 많지만, 크라우드소싱 방식은 수입이 프로젝트 물량에 좌우돼 안정성이 낮을 수 있다.

사회적 기여

개인정보보호위원회는 2024년 AI 개발·서비스를 위한 공개된 개인정보 처리 안내서를 발간해, AI 학습데이터를 가공하는 과정에서 지켜야 할 개인정보 처리 기준을 제시했다.[3] 라벨러가 이런 기준을 준수하며 작업하는 것은 데이터 주체의 프라이버시를 보호하는 사회적 역할과 맞닿아 있다.

임금 정보

초보 라벨러의 경우 연 2,400만~3,000만 원 수준이며, 전문 분야(의료·자율주행 등) 경력자는 연 3,500만 원 이상을 받을 수 있다. 크라우드소싱 방식은 건당 수수료 형태로 시급 환산 시 최저임금 수준인 경우도 있다.[4]

여담

  • •

    크라우드웍스에 따르면 2024년 7월 기준 이 플랫폼을 통해 보수를 받고 활동 중인 데이터 작업자는 60만명에 이르며, 처리한 프로젝트는 5000여개, 상세 데이터 수는 2억6000개에 달한다.[5]

  • •

    TIME 보도에 따르면 OpenAI는 챗GPT의 유해 콘텐츠 필터링을 위한 데이터 라벨링을 케냐 노동자에게 맡겼는데, 이들이 실제 받은 시급은 2달러 안팎에 그쳐 국제적 노동 착취 논란이 일었다.[6]

  • •

    위키백과에 따르면 RLHF(인간 피드백 기반 강화학습)는 인간 평가자의 선호도 데이터를 보상 모델 학습에 활용해 언어모델의 출력을 사람이 원하는 방향으로 조정하는 기법이다.[7]

  • •

    크라우드웍스는 코로나19 팬데믹을 계기로 인공지능 확산이 가속화되며 크라우드소싱 방식의 데이터 구축이 새로운 해법으로 떠올랐다고 설명한다.[8]